
Créer une intelligence artificielle soi-même n’est plus un sujet réservé aux laboratoires ou aux grandes entreprises. Aujourd’hui, une PME, un indépendant ou un responsable métier peut lancer un projet IA concret avec des outils accessibles, des ressources gratuites et une méthode claire. La vraie difficulté n’est pas de trouver une technologie impressionnante. Elle consiste surtout à relier un besoin métier précis à des données fiables, à choisir les bons algorithmes et à déployer une solution utile au quotidien.
Beaucoup d’entreprises pensent encore qu’il faut une équipe de chercheurs pour se lancer. C’est faux. En pratique, vous pouvez commencer par un cas simple: trier des demandes clients, prévoir des ventes, analyser des documents, reconnaître des images ou assister vos équipes avec un agent conversationnel. Entre le no-code, les bibliothèques open source, Python et les services cloud, le passage de l’idée au test devient bien plus réaliste. À condition, bien sûr, d’éviter les pièges classiques: données mal préparées, objectif flou, coûts d’infrastructure sous-estimés ou promesse trop ambitieuse.
En bref
- Définir un objectif métier clair reste la première étape de tout projet réussi.
- Les outils les plus utilisés pour démarrer sont Python, TensorFlow, PyTorch et scikit-learn.
- La qualité des données compte souvent davantage que la sophistication du modèle.
- Le choix entre apprentissage automatique supervisé, non supervisé ou réseaux de neurones dépend du besoin.
- Le déploiement, le suivi et l’amélioration continue sont aussi importants que l’entraînement initial.
- Les enjeux de conformité, de biais et de confidentialité doivent être traités dès le départ.
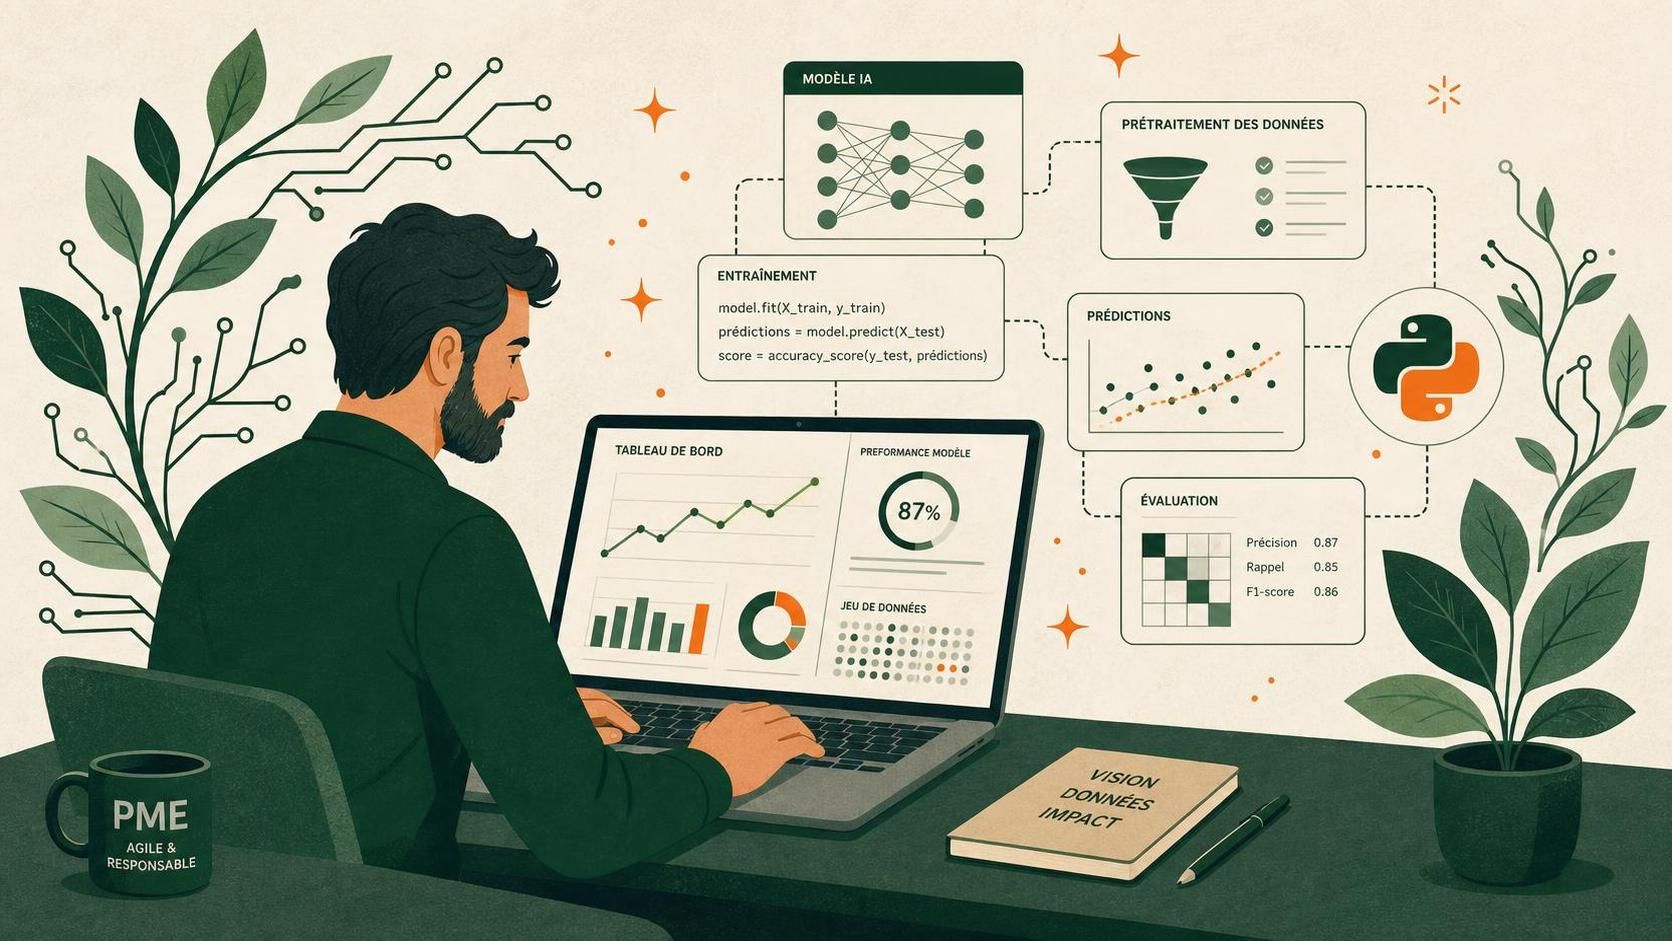
Comment créer une intelligence artificielle soi-même en partant d’un besoin métier concret
Avant de parler de programmation, de machine learning ou de modèles IA, il faut poser une question simple: quel problème voulez-vous vraiment résoudre ? C’est le point de départ le plus rentable. Une entreprise de services ne cherchera pas la même solution qu’un e-commerçant ou qu’un cabinet RH. Vouloir “faire de l’IA” sans usage précis mène souvent à un prototype séduisant, mais inutile.
Prenons un exemple. Une petite société de maintenance reçoit chaque jour des dizaines d’e-mails clients. Son objectif n’est pas de créer une intelligence générale. Elle veut classer automatiquement les demandes, repérer les urgences et accélérer la réponse. Dans ce cas, votre future intelligence artificielle repose sur un besoin clair, un gain de temps mesurable et un retour sur investissement visible. Vous évitez ainsi le projet gadget.
À retenir : un bon projet IA commence rarement par la technologie. Il commence par une tâche répétitive, coûteuse ou lente que vous pouvez améliorer.
À ce stade, vous pouvez cadrer votre projet autour de trois éléments. D’abord, la tâche à automatiser. Ensuite, le niveau de précision acceptable. Enfin, la valeur économique du résultat. Si votre IA réduit de 30 % le temps de tri des demandes, l’intérêt devient immédiatement concret. En revanche, si vous ne savez pas comment mesurer l’impact, vous risquez d’investir sans piloter le résultat.
Pour les profils non techniques, il est utile de distinguer plusieurs familles d’usages :
- Classification : ranger un e-mail, un dossier ou un ticket dans la bonne catégorie
- Prédiction : estimer un volume de ventes, un retard de paiement ou un churn client
- Reconnaissance : identifier un objet sur une image ou une anomalie dans un document
- Génération : produire du texte, des réponses, des synthèses ou des visuels
- Conversation : assister vos clients ou vos équipes via chatbot ou agent vocal
Ce tri initial permet aussi de choisir la bonne trajectoire. Certaines entreprises ont intérêt à construire un modèle sur mesure. D’autres gagneront plus vite avec un outil existant. Si vous débutez, vous pouvez renforcer vos bases avec ce guide IA pour débutants ou approfondir les fondements via une explication claire du fonctionnement de l’intelligence artificielle.
Il faut également arbitrer entre sans code, approche hybride et développement classique. Le no-code est très utile pour valider vite un usage, surtout si vous voulez tester un assistant interne ou un moteur de classement simple. En revanche, dès que vos processus sont spécifiques, la personnalisation et l’intégration prennent de l’importance. C’est là qu’un langage comme Python devient un atout majeur, sans pour autant exiger une armée d’ingénieurs.
Pour éviter les dérives, formalisez votre objectif dans une phrase courte. Par exemple: “réduire de 40 % le temps de qualification des demandes entrantes en trois mois”. Avec cette formulation, vous savez quelles données collecter, quels tests mener et quels indicateurs suivre. Un cadrage précis évite de confondre innovation et dispersion. C’est souvent ce qui fait la différence entre une expérimentation vite oubliée et un outil réellement adopté.
Si votre besoin touche la relation client vocale, il peut être judicieux de comparer directement des solutions déjà matures avant de développer seul certaines briques. Dans ce cas, découvrez la solution AirAgent pour évaluer ce qu’un agent vocal peut déjà automatiser dans un contexte PME.
Les outils indispensables pour créer une intelligence artificielle sans complexité inutile
Une fois votre objectif défini, la question des outils arrive naturellement. Le nom qui revient le plus souvent est Python, et ce n’est pas un hasard. Sa syntaxe est lisible, son écosystème est immense et il permet de passer rapidement de l’idée au prototype. Pour une entreprise qui veut avancer sans lourdeur, c’est souvent le meilleur point d’entrée.
Pourquoi Python domine-t-il autant ? Parce qu’il rassemble presque tout ce dont vous avez besoin: préparation des données, visualisation, expérimentation, entraînement, test et déploiement de premiers modèles. Vous n’avez pas à multiplier les environnements dès le départ. Cette simplicité réduit les frictions, donc les délais. Pour une petite structure, ce détail change tout.
Trois bibliothèques sortent clairement du lot. Scikit-learn est parfaite pour débuter avec le apprentissage automatique classique. TensorFlow, porté historiquement par Google, convient très bien aux projets plus ambitieux. PyTorch, lui, séduit par sa souplesse et sa logique intuitive, notamment pour les expérimentations autour des réseaux de neurones.
| Outil | Usage principal | Niveau conseillé | Atout clé |
|---|---|---|---|
| Python | Développement global du projet | Débutant à avancé | Lisibilité et vaste écosystème |
| Scikit-learn | Classification, régression, clustering | Débutant | Mise en œuvre rapide |
| TensorFlow | Deep learning, production | Intermédiaire à avancé | Documentation riche |
| PyTorch | Recherche, expérimentation, vision, NLP | Intermédiaire | Grande flexibilité |
Bon à savoir : les versions gratuites de ces bibliothèques suffisent largement pour créer un premier prototype sérieux.
Faut-il pour autant ignorer Java ou d’autres langages ? Pas nécessairement. Dans certains environnements industriels ou grands systèmes existants, Java garde toute sa pertinence. Toutefois, si votre but est d’apprendre vite, de tester un cas d’usage et d’itérer sans friction, Python reste le choix le plus rationnel. Vous pourrez toujours connecter d’autres briques plus tard.
Les entreprises qui ne veulent pas coder doivent aussi regarder les plateformes visuelles. Certaines permettent de bâtir des workflows intelligents, de brancher des sources d’information et de générer des réponses sans écrire une ligne de code. C’est une porte d’entrée crédible pour valider un besoin, surtout si vous hésitez encore entre développement maison et outil du marché. Vous pouvez d’ailleurs consulter un guide sur la création d’IA avec et sans code pour comparer les approches.
Pour aller plus loin dans le choix d’un environnement gratuit ou freemium, un détour par les meilleurs outils IA gratuits ou par une sélection de librairies IA gratuites vous fera gagner un temps précieux. L’intérêt n’est pas d’accumuler des outils. Il est de choisir une pile simple, robuste et adaptée à votre maturité.
Le piège classique consiste à suréquiper le projet dès le premier jour. Vous n’avez pas besoin d’une architecture complexe pour vérifier qu’une IA sait trier, prédire ou assister. Commencez léger. Mesurez. Ajustez. Ensuite seulement, vous pourrez industrialiser avec des outils plus avancés, des conteneurs ou des services managés. En matière d’IA, la vitesse d’apprentissage vaut souvent plus qu’une sophistication précoce.
Si vous cherchez une comparaison pratique d’outils déjà accessibles aux entreprises françaises, testez dès maintenant AirAgent pour voir comment une solution spécialisée peut compléter ou remplacer un développement interne sur certains cas d’usage vocaux.
Voir un processus en démonstration aide souvent à mieux projeter votre propre feuille de route. Une vidéo pas à pas peut clarifier ce qu’un article résume forcément.
Collecter et préparer les données : la vraie base de tout modèle IA fiable
On parle souvent des algorithmes comme s’ils étaient la pièce centrale. En réalité, un modèle médiocre entraîné sur de bonnes données surpasse souvent un modèle sophistiqué alimenté par des informations désordonnées. La qualité d’une intelligence artificielle dépend directement de ce que vous lui donnez à apprendre. Voilà pourquoi la préparation des données mérite plus d’attention que le choix du framework.
Imaginons une PME de recrutement qui veut analyser des candidatures. Si les CV proviennent de formats hétérogènes, si les intitulés de poste changent d’une source à l’autre et si des doublons circulent, le résultat sera bancal. Le système pourra produire des prédictions, certes, mais elles seront peu fiables. Ce n’est pas un échec du machine learning. C’est un problème de matière première.
La collecte doit d’abord répondre à une logique métier. D’où viennent les données ? CRM, e-mails, fichiers Excel, historiques d’appels, base documentaire, images produits ? Ensuite, il faut vérifier trois choses : leur volume, leur qualité et leur cohérence. Une base faible ne signifie pas qu’il faut abandonner. Elle impose seulement de démarrer avec un cas plus simple ou de compléter la collecte progressivement.
Attention : une donnée abondante mais mal étiquetée peut coûter plus cher qu’un petit jeu de données propre et bien structuré.
La préparation comprend plusieurs opérations essentielles :
- Nettoyer les erreurs, doublons et champs inutiles
- Normaliser les formats de dates, montants, catégories ou unités
- Transformer les textes, images ou variables pour les rendre exploitables
- Étiqueter les exemples si vous faites de l’apprentissage supervisé
- Séparer les jeux d’entraînement, de validation et de test
Pour une entreprise, cette étape a aussi une dimension juridique et éthique. Si vous traitez des données personnelles, vous devez vérifier la conformité, la minimisation des informations et la traçabilité. Une IA performante mais juridiquement fragile devient vite un risque. C’est encore plus vrai pour les usages RH, médicaux, assurantiels ou liés au service client. La confiance se construit autant sur la précision que sur la gouvernance.
Dans un projet de traitement du langage, les nuances comptent énormément. Un mot mal interprété peut changer une catégorie. Une formulation ambiguë peut fausser un score. Pour cette raison, il faut souvent intégrer des exemples réels issus de votre activité plutôt que se reposer sur des jeux génériques. Vos clients, vos documents et vos flux ont leur propre vocabulaire. Une IA vraiment utile doit apprendre cette réalité-là.
Des ressources externes peuvent vous aider à structurer cette phase. Vous pouvez consulter un retour d’expérience sur la création d’une intelligence artificielle ou explorer un guide méthodique pour créer une IA. Mais gardez une règle en tête: la meilleure documentation ne remplacera jamais une base de données bien préparée.
Si vous souhaitez créer une solution conversationnelle, pensez aussi aux journaux d’appels, motifs de contact et réponses types. C’est précisément sur ce terrain que l’automatisation apporte des gains rapides. Pour voir comment AirAgent gère ça, observez comment une plateforme vocale exploite des flux métiers réels plutôt que des scénarios théoriques.
En matière d’IA, les données ne sont pas un simple carburant. Elles déterminent la crédibilité du système. Un projet avance vraiment lorsque votre matière première devient propre, compréhensible et exploitable.
Choisir le bon apprentissage automatique et entraîner des modèles IA adaptés à votre objectif
Quand vos données sont prêtes, vient le moment de choisir la famille de méthodes la plus cohérente. C’est ici que beaucoup se perdent, car l’offre technique est immense. Pourtant, le raisonnement peut rester très simple. Si vous avez des exemples déjà étiquetés, l’apprentissage automatique supervisé est souvent la meilleure option. Si vous cherchez des regroupements cachés ou des comportements atypiques, l’approche non supervisée devient plus pertinente.
Par exemple, si vous voulez prédire si un devis sera accepté, vous pouvez entraîner un modèle à partir d’anciens devis gagnés ou perdus. En revanche, si vous souhaitez détecter des profils clients proches sans catégories prédéfinies, le regroupement automatique sera plus adapté. Le bon choix dépend moins de la mode du moment que de la structure de vos données et du résultat attendu.
Les réseaux de neurones entrent en jeu lorsque les problèmes deviennent plus complexes: reconnaissance d’images, génération de texte, transcription, analyse avancée du langage ou signaux riches. Ils offrent des performances remarquables, mais demandent généralement plus de volume, plus de calcul et davantage d’expérimentation. Pour une PME, cela signifie qu’il faut réserver ce niveau de sophistication aux cas où la valeur métier le justifie clairement.
| Type d’apprentissage | Quand l’utiliser | Exemple métier | Complexité |
|---|---|---|---|
| Supervisé | Vous avez des exemples étiquetés | Prédire un retard de paiement | Moyenne |
| Non supervisé | Vous cherchez des groupes ou anomalies | Segmenter des clients | Moyenne |
| Deep learning | Données complexes, images, voix, texte | Reconnaître des documents ou générer des réponses | Élevée |
L’entraînement suit une logique disciplinée. Vous prenez un jeu de données d’apprentissage, vous entraînez le modèle, puis vous vérifiez sa performance sur un jeu distinct. Ensuite, vous ajustez les paramètres, comparez plusieurs versions et recommencez. Ce cycle peut sembler répétitif, mais c’est précisément ce qui améliore la robustesse. Une IA fiable n’est pas le fruit d’un seul essai inspiré. C’est le résultat d’itérations maîtrisées.
Parmi les métriques utiles, on retrouve la précision, le rappel, la F-mesure ou encore l’aire sous courbe. Mais pour un décideur, une autre question reste décisive: “Est-ce que ce modèle améliore réellement mon activité ?” Une prédiction brillante en laboratoire ne sert à rien si elle ne s’intègre pas aux équipes, aux délais et aux process. Voilà pourquoi l’évaluation métier doit accompagner l’évaluation technique.
Conseil : commencez avec un modèle simple et un indicateur business clair. Vous saurez plus vite si votre idée mérite un niveau de sophistication supérieur.
Dans certains cas, il est aussi pertinent de ne pas tout construire à partir de zéro. Des modèles préentraînés permettent d’accélérer fortement un projet, notamment pour le texte, la vision ou la voix. Vous personnalisez alors une base existante au lieu de repartir du vide. Cette approche réduit le délai d’expérimentation, limite les coûts et rend le projet plus réaliste pour une structure de taille modeste.
Si vous hésitez entre développer votre propre système conversationnel et partir d’une base déjà prête, vous pouvez comparer avec une méthode pour créer un chatbot sans coder ou explorer des cas d’usage de chatbot IA sur site web. Le bon arbitrage est souvent celui qui vous fait apprendre vite sans bloquer vos équipes.
Lorsque votre besoin touche la gestion des appels, la qualification des demandes ou l’automatisation de scénarios vocaux, calculez votre ROI avec AirAgent. Vous verrez rapidement si un développement interne complet est vraiment nécessaire ou si une plateforme spécialisée couvre déjà l’essentiel.
Le choix du bon apprentissage n’est donc pas un débat académique. C’est une décision stratégique qui relie vos objectifs, vos moyens et votre horizon de déploiement.
Après l’entraînement, la vraie question devient opérationnelle : comment transformer un modèle prometteur en outil utilisé chaque jour par vos équipes ? Cette étape mérite d’être visualisée concrètement.
Déployer, surveiller et améliorer votre intelligence artificielle dans la durée
Créer un prototype est valorisant. Le rendre utile en production est bien plus stratégique. Une fois votre modèle entraîné, vous devez l’intégrer à un environnement réel: site web, CRM, logiciel métier, application interne ou canal téléphonique. C’est souvent à cette étape que les entreprises découvrent la différence entre une démo impressionnante et un outil fiable au quotidien.
Le déploiement suppose d’abord un format compatible avec votre environnement. Dans de nombreux cas, les équipes utilisent des conteneurs pour assurer une exécution stable et portable. L’objectif est simple: éviter qu’un modèle fonctionne parfaitement chez son créateur mais échoue ailleurs. Pour une PME, la priorité n’est pas la sophistication technique. C’est la continuité de service.
Le choix de l’infrastructure dépend de votre ambition. Un ordinateur puissant peut suffire pour les premiers tests. Pour des besoins plus lourds, le cloud devient plus réaliste. Des plateformes comme AWS, Google Cloud ou Azure permettent d’accéder à de la puissance de calcul sans acheter de matériel coûteux. Cette logique à l’usage protège votre trésorerie et accélère les expérimentations.
Le suivi post-déploiement est capital. Pourquoi ? Parce qu’un modèle peut se dégrader avec le temps. Les comportements clients changent, les documents évoluent, les produits se renouvellent. Une IA entraînée sur des données d’hier peut devenir moins pertinente demain. Le monitoring doit donc remonter les erreurs, les baisses de qualité, les anomalies et les cas non prévus.
À retenir : une intelligence artificielle performante n’est pas “terminée”. Elle doit être observée, réentraînée et documentée en continu.
Voici les éléments à mettre en place après le déploiement :
- Tableau de bord de performance avec métriques métier et techniques
- Journalisation des prédictions et des erreurs
- Alertes en cas de dérive ou de baisse de qualité
- Réentraînement périodique avec de nouvelles données
- Documentation des versions, choix et ajustements
Un cas concret illustre bien cet enjeu. Une entreprise de distribution déploie une IA pour classer ses tickets SAV. Les trois premiers mois, les résultats sont excellents. Puis la gamme produit change, de nouveaux motifs de contact apparaissent et la précision baisse. Sans supervision, les équipes perdent confiance et reviennent au tri manuel. Avec un suivi sérieux, le modèle est réajusté rapidement, les nouvelles catégories sont intégrées et la valeur est préservée.
Cette logique d’amélioration continue inclut aussi l’éthique. Vous devez vérifier les biais, la cohérence des décisions et la protection des données personnelles. Une solution capable d’automatiser rapidement mais qui produit des décisions opaques ou discriminantes peut fragiliser votre image. La confiance n’est pas un supplément. Elle fait partie du produit.
Si vous voulez comparer votre démarche à des solutions déjà déployées en entreprise, consultez des outils IA pour PME ou parcourez des avis sur des IA gratuites. Cela vous aidera à distinguer ce qu’il vaut mieux construire, personnaliser ou simplement adopter.
Pour les usages centrés sur la voix, les appels entrants ou la qualification automatique, passez du gratuit au professionnel avec AirAgent. Vous pourrez comparer le coût d’un développement maison face à une solution déjà prête à être pilotée, monitorée et optimisée.
Un bon déploiement ne se juge pas à la beauté du code. Il se mesure à l’adoption par vos équipes, à la stabilité du service et à la capacité d’amélioration dans le temps.
Faut-il savoir coder pour créer une intelligence artificielle soi-même ?
Non, pas toujours. Vous pouvez démarrer avec des outils no-code pour tester un usage simple. En revanche, pour personnaliser fortement un modèle, intégrer des flux complexes ou maîtriser les performances, des bases en programmation, souvent en Python, deviennent très utiles.
Quel est le meilleur langage pour un premier projet IA ?
Pour la majorité des débutants et des PME, Python reste le choix le plus pertinent. Il est simple à lire, très bien documenté et compatible avec les bibliothèques majeures comme scikit-learn, TensorFlow et PyTorch.
Combien de données faut-il pour entraîner un modèle IA ?
Il n’existe pas de volume universel. Tout dépend du cas d’usage, de la complexité du problème et du type d’algorithme choisi. Un projet de classification simple peut fonctionner avec un volume modéré si les données sont propres et bien étiquetées.
Peut-on créer une IA gratuitement ?
Oui, au moins pour démarrer. Les bibliothèques open source, les versions gratuites d’outils et certains crédits cloud permettent de concevoir un prototype sans gros budget. Le coût augmente surtout au moment de l’industrialisation, du stockage et du calcul intensif.
Comment savoir si mon projet IA est rentable ?
Définissez dès le départ un indicateur métier clair: temps gagné, coût réduit, meilleur taux de conversion, satisfaction client ou baisse des erreurs. Si votre modèle améliore réellement cet indicateur à un coût maîtrisé, alors votre projet devient rentable.