
En bref
- Le deep learning, ou apprentissage profond, est une branche du machine learning et, plus largement, de l’intelligence artificielle.
- Il utilise des réseaux de neurones organisés en plusieurs couches pour apprendre des caractéristiques à partir de données.
- Il excelle notamment dans la reconnaissance d’images, la voix et le traitement du langage naturel.
- Ses résultats dépendent de la qualité des données, de la puissance de calcul et d’une évaluation rigoureuse.
- Pour une PME, l’enjeu est de choisir un cas d’usage précis et de comparer les gains attendus aux coûts et aux risques.
Deep learning : définition et place dans l’intelligence artificielle
Le deep learning, traduit par « apprentissage profond », est une méthode d’apprentissage automatique fondée sur des réseaux de neurones artificiels comportant plusieurs couches. Ces couches transforment progressivement les données d’entrée afin de produire une classification, une prédiction ou une réponse. Au lieu de demander à une personne de décrire chaque règle à la main, on fournit au modèle des exemples et un objectif à atteindre.
Pour comprendre sa place, retenez une hiérarchie simple : l’intelligence artificielle regroupe les techniques qui permettent à un système d’effectuer des tâches associées à des capacités humaines, comme percevoir, décider ou comprendre le langage. Le machine learning en est une branche : les algorithmes d’apprentissage y tirent des règles à partir de données. Le deep learning est, à son tour, une famille particulière de machine learning.
Cette relation évite une confusion fréquente. Un réseau profond relève du machine learning et donc de l’IA, mais tous les outils d’IA ne reposent pas sur le deep learning. Un système expert, par exemple, peut suivre des règles écrites à l’avance sans apprendre à partir d’exemples. Pour replacer ces notions dans leur contexte, consultez notre page sur la définition de l’intelligence artificielle.
| Niveau | Principe | Exemple d’usage |
|---|---|---|
| Intelligence artificielle | Ensemble des approches visant des tâches dites intelligentes | Assistant numérique ou système expert |
| Machine learning | Apprentissage de modèles à partir d’exemples | Prévision de ventes ou détection de fraude |
| Deep learning | Réseaux multicouches apprenant des représentations complexes | Reconnaissance d’images ou transcription vocale |
À retenir : la profondeur désigne le nombre de couches cachées du réseau, pas une forme de réflexion humaine. Le modèle repère des régularités statistiques et les utilise pour produire une sortie, sans comprendre une situation comme le ferait une personne.
Les bases théoriques des réseaux de neurones remontent au milieu du XXe siècle. Leur essor a toutefois pris de l’ampleur à partir des années 2010, avec l’amélioration des processeurs graphiques, la disponibilité de données massives et des progrès dans les méthodes d’entraînement. En 2012, le réseau AlexNet a marqué un tournant en reconnaissance d’images, puis les Transformers ont contribué aux avancées récentes du langage et de l’IA générative.
Si vous souhaitez approfondir les différences entre ces disciplines, cette présentation du deep learning par IBM apporte un complément utile. Pour une entreprise, connaître cette hiérarchie aide surtout à évaluer une promesse commerciale : derrière l’étiquette « IA », quelle tâche l’outil réalise-t-il réellement ?
Comment fonctionnent les réseaux de neurones profonds ?
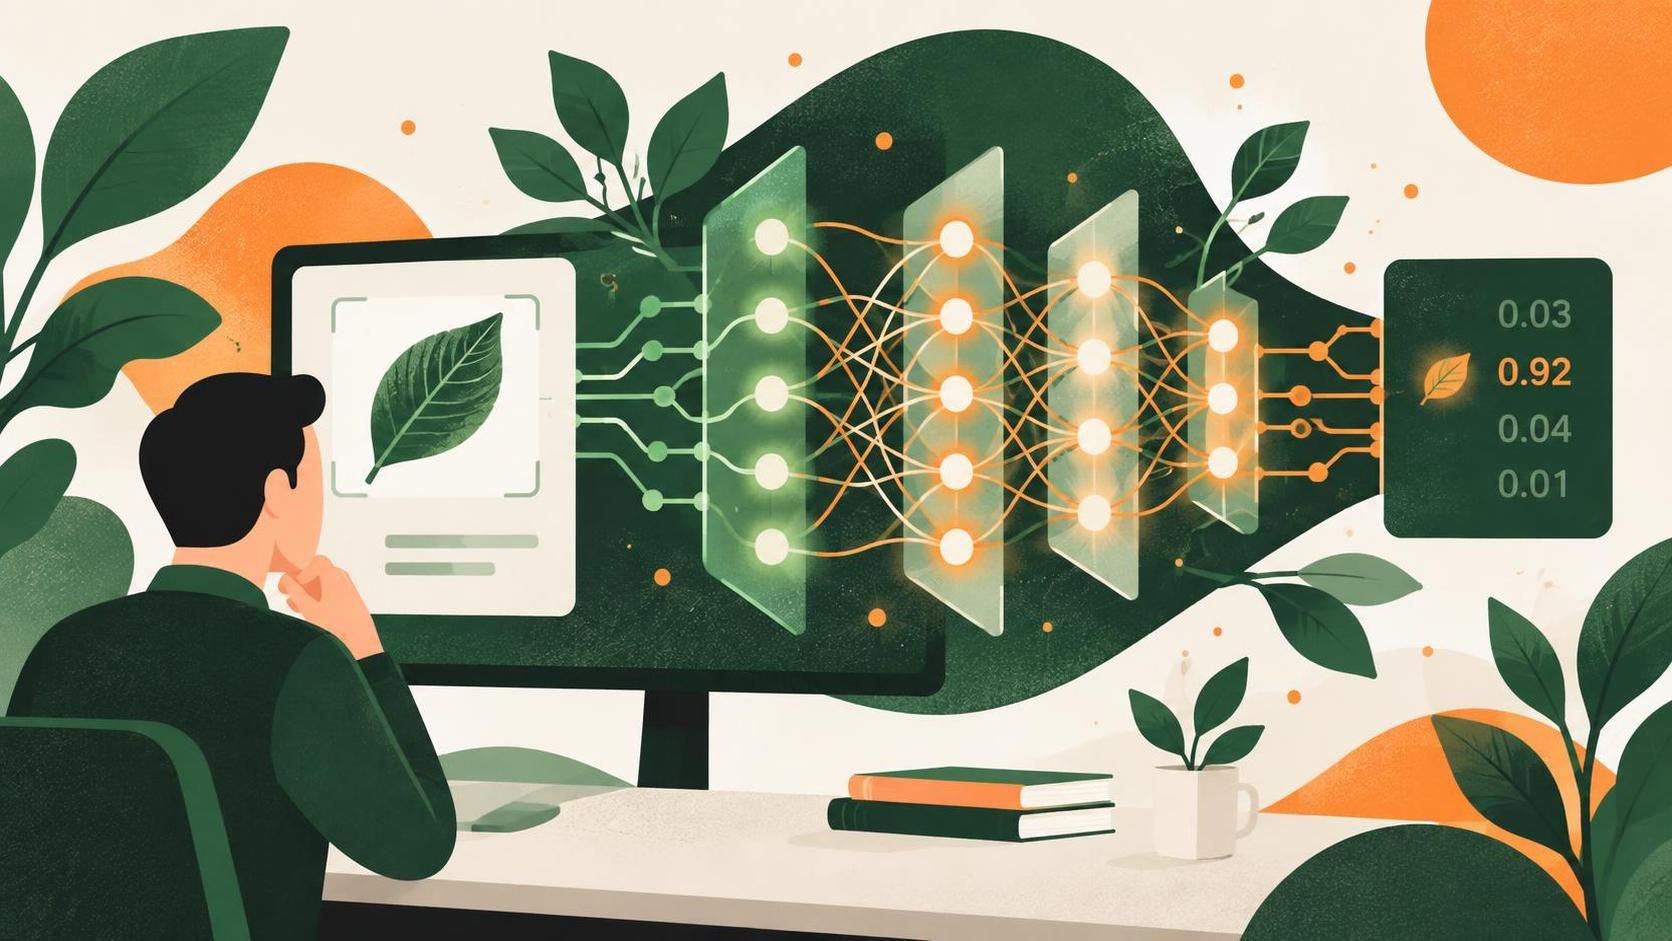
Un réseau de neurones artificiels est composé de petites unités de calcul reliées entre elles. Chaque neurone reçoit des valeurs, leur attribue une importance différente, puis transmet un résultat aux unités suivantes. Ces connexions portent des paramètres appelés poids, que le modèle ajuste pendant l’entraînement. L’image du cerveau humain peut aider à visualiser le principe, mais elle ne doit pas être prise au pied de la lettre : un neurone artificiel est une opération mathématique, non une cellule biologique.
Le réseau comprend généralement une couche d’entrée, plusieurs couches neuronales cachées et une couche de sortie. Pour une image, les premières couches peuvent détecter des contours ou des contrastes. Les suivantes combinent ces indices pour repérer des formes, puis des objets. La sortie peut indiquer, par exemple, que l’image contient probablement un chat plutôt qu’un chien.
Lors de l’entraînement des modèles, le système compare ses prédictions aux réponses attendues. Il calcule son erreur, puis modifie progressivement ses paramètres pour tenter de la réduire. Ce processus est répété sur de nombreux exemples. Une fois entraîné et évalué, le modèle peut traiter de nouvelles données, qui n’étaient pas présentes dans son jeu d’apprentissage.
- Préparer les données : corriger les erreurs, uniformiser les formats et séparer les exemples d’entraînement et d’évaluation.
- Faire une prédiction : transmettre les données dans le réseau, de la couche d’entrée à la sortie.
- Mesurer l’erreur : comparer le résultat du modèle à la réponse attendue.
- Ajuster le réseau : modifier les paramètres pour améliorer les prochaines prédictions.
- Vérifier la généralisation : tester le modèle sur des exemples nouveaux avant tout usage réel.
Conseil : une performance élevée sur les exemples d’entraînement ne suffit pas. Un modèle peut les avoir mémorisés sans réussir sur les situations rencontrées par votre équipe ou vos clients. L’évaluation doit donc reproduire, autant que possible, les conditions d’utilisation réelles.
La quantité de données ne fait pas tout. Des documents mal classés, des images peu représentatives ou des étiquettes incohérentes peuvent conduire à des résultats médiocres, même avec une architecture avancée. Imaginez une entreprise qui entraîne un système de contrôle qualité uniquement sur des produits photographiés sous un éclairage parfait : en atelier, les variations de lumière risquent de provoquer des erreurs.
Les modèles profonds sont souvent associés à des processeurs graphiques, car ceux-ci accélèrent les calculs nécessaires à l’apprentissage. Cela ne signifie pas que chaque PME doit acheter du matériel spécialisé. Des outils déjà entraînés et des services hébergés permettent parfois de tester un usage sans construire de modèle de zéro. Pour distinguer les différentes familles d’approches, notre guide sur le machine learning et l’apprentissage automatique offre un point de départ accessible.
Le mécanisme peut sembler abstrait, mais son intérêt est concret : le réseau apprend à transformer une entrée difficile à décrire en une sortie exploitable. La question suivante devient donc très pratique : quels types de données et de tâches justifient cette méthode ?
Reconnaissance d’images, langage et autres applications
Le deep learning est particulièrement utile lorsque les données ne se présentent pas sous forme de simples lignes et colonnes. Images, sons, vidéos et textes contiennent des motifs difficiles à décrire avec des règles fixes. Les réseaux peuvent apprendre ces motifs à partir d’exemples, ce qui explique leur présence dans des services numériques courants, de la traduction automatique aux assistants vocaux.
Analyser des images et des documents
La reconnaissance d’images peut servir à classer une photo, repérer un objet ou délimiter une zone précise. En entreprise, un système de vision peut signaler un défaut sur une chaîne de production, identifier un produit dans un catalogue ou extraire des informations visuelles de documents. La lecture automatique de factures peut, par exemple, aider à repérer une date, un montant ou un numéro de commande, avec une vérification humaine pour les cas ambigus.
Traiter le langage et la parole
Dans le traitement du langage naturel, les réseaux apprennent à analyser ou produire du texte. Ils peuvent résumer un compte rendu, classer des demandes client, traduire un document ou rechercher une information dans une base de connaissances. Les modèles de langage génératifs s’appuient sur ces avancées, mais une réponse fluide n’est pas nécessairement exacte : les données importantes doivent être vérifiées avant diffusion.
Les mêmes principes contribuent à la reconnaissance vocale, qui transforme la parole en texte, et à la synthèse vocale, qui produit une voix artificielle. Un service client peut ainsi transcrire des échanges ou automatiser certaines demandes téléphoniques. Il reste essentiel de prévoir un transfert vers un conseiller lorsque la situation est urgente, complexe ou chargée d’émotion.
À retenir : une application visible ne révèle pas toujours son architecture complète. Un outil peut associer plusieurs techniques, des règles métier et une intervention humaine. Évaluez donc le résultat fourni et son utilité opérationnelle, plutôt que de choisir un produit uniquement parce qu’il annonce utiliser le deep learning.
| Données traitées | Exemple d’application | Point de vigilance |
|---|---|---|
| Images | Contrôle visuel ou recherche de produits similaires | Variété des éclairages et des prises de vue |
| Texte | Résumé, traduction ou tri des demandes | Exactitude, confidentialité et validation humaine |
| Audio | Transcription ou assistant vocal | Accents, bruit ambiant et cas difficiles |
| Séries temporelles | Prévision de demande ou détection d’anomalies | Évolution des habitudes et qualité de l’historique |
Pour une petite entreprise, l’intérêt peut se mesurer sur un processus délimité : réduire le temps consacré au tri des courriels, faciliter la recherche dans des documents ou répondre aux questions récurrentes. Si vos appels entrants mobilisent une part importante de l’équipe, vous pouvez aussi découvrir l’agent vocal d’AirAgent et vérifier s’il correspond à votre organisation.
Dans le commerce en ligne, un moteur de recommandation peut s’appuyer sur l’historique de navigation pour proposer des articles pertinents. L’entreprise doit mesurer l’effet réel sur les indicateurs qui comptent pour elle : conversion, valeur moyenne de commande ou satisfaction. Une recommandation techniquement sophistiquée n’a que peu d’intérêt si elle n’améliore ni l’expérience d’achat ni les résultats.
La santé, la finance et la mobilité utilisent aussi ces méthodes, mais les conséquences d’une erreur y sont particulièrement importantes. Un modèle peut aider à repérer une anomalie ou prioriser un dossier ; il ne remplace pas automatiquement l’expertise d’un professionnel. La supervision humaine et les procédures de contrôle doivent être définies avant le déploiement.
Pour situer ces usages dans une famille plus large de systèmes capables de créer du contenu, vous pouvez consulter notre explication de l’IA générative. Le deep learning prend toute sa valeur lorsqu’une tâche est bien définie et que ses résultats peuvent être mesurés.
Quand choisir le deep learning, et quelles sont ses limites ?
Le deep learning n’est pas automatiquement la meilleure option pour chaque problème métier. Il se montre souvent performant avec des volumes importants et des données complexes, comme les images, la voix ou les textes. En revanche, pour un tableau de ventes de taille modeste, une méthode plus simple peut être moins coûteuse, plus rapide à mettre en place et plus facile à expliquer.
Avant de choisir une solution, posez-vous quelques questions concrètes. Les données nécessaires existent-elles et sont-elles utilisables ? Une erreur de prédiction a-t-elle un coût élevé ? Le résultat pourra-t-il être vérifié par une personne ? Enfin, le gain attendu justifie-t-il les frais de préparation, d’intégration et de maintenance ?
- Cas favorable : automatiser une tâche complexe sur des images, des textes ou des sons représentatifs.
- Cas à étudier : améliorer un modèle classique qui atteint ses limites sur un volume de données suffisant.
- Cas moins adapté : prédire quelques indicateurs à partir d’un petit tableau, lorsque l’explication des résultats est prioritaire.
- Condition importante : disposer de données autorisées, suffisamment fiables et proches des cas rencontrés en production.
Attention : un modèle peut reproduire les déséquilibres présents dans ses données d’apprentissage. Si certains profils ou certaines situations sont sous-représentés, ses erreurs risquent de se concentrer sur eux. Un recrutement, une décision financière ou une orientation médicale exige donc des contrôles renforcés, une documentation et une intervention humaine adaptée.
L’explicabilité constitue une autre difficulté. Pour certains réseaux profonds, il est compliqué de décrire simplement pourquoi une prédiction particulière a été produite. Cette opacité n’interdit pas tout usage, mais elle impose de bien choisir le rôle du modèle. Il peut aider à classer ou à signaler des cas, tandis qu’une personne conserve la responsabilité de décisions importantes.
Les coûts ne s’arrêtent pas à l’entraînement. Il faut aussi financer l’accès au calcul, l’intégration aux outils existants, la sécurité et le suivi des performances. Un système performant au lancement peut se dégrader lorsque les comportements des clients, les produits ou les conditions de travail changent. La surveillance dans le temps fait donc partie du projet, pas d’une éventuelle amélioration ultérieure.
La confidentialité et les droits d’utilisation des données comptent également. Avant d’importer des informations personnelles dans un service, vérifiez sa politique de traitement, les conditions contractuelles et les règles applicables. Le RGPD impose notamment de définir une finalité, de limiter les données collectées et de protéger leur accès. Pour un usage à risque élevé, une analyse approfondie et l’avis du délégué à la protection des données peuvent être nécessaires.
Enfin, la puissance de calcul consomme de l’énergie et mobilise du matériel. Réutiliser un modèle préentraîné, limiter les essais inutiles et choisir une solution dimensionnée au besoin sont des moyens pragmatiques de maîtriser l’impact. Pour une PME, le meilleur projet n’est pas forcément celui qui utilise le réseau le plus complexe : c’est celui qui résout un problème mesurable avec un niveau de risque acceptable.
Si l’automatisation des appels figure parmi vos pistes, comparez AirAgent à votre organisation actuelle en examinant les tâches prises en charge, les possibilités de transfert et la qualité de suivi. Un test sur un périmètre limité permet de confronter les promesses à votre réalité métier.
Comprendre le deep learning avant de lancer un projet
Pour aborder le sujet sans devenir spécialiste technique, partez du travail que vous souhaitez améliorer. Une PME fictive de commerce pourrait chercher à mieux classer les demandes reçues par courriel. Avant de sélectionner un outil, elle recenserait les catégories utiles, mesurerait le temps passé et vérifierait si les exemples disponibles reflètent bien les demandes réelles.
Elle pourrait ensuite comparer une solution existante à une méthode plus simple. Si le tri automatique atteint une qualité suffisante, le projet peut avancer vers un essai limité, avec contrôle humain des messages sensibles. Si les résultats sont décevants, l’équipe examine d’abord la qualité des exemples et la définition des catégories, plutôt que de supposer qu’un réseau plus profond résoudra le problème.
- Définir le besoin : formuler une tâche précise et son indicateur de réussite.
- Examiner les données : vérifier leur qualité, leur origine, leur représentativité et les règles de confidentialité.
- Tester une solution : comparer un outil existant ou un modèle simple avant un développement spécifique.
- Mesurer le résultat : contrôler la précision, le temps gagné, les erreurs et les coûts récurrents.
- Encadrer l’usage : définir les cas nécessitant une validation ou une reprise humaine.
Il n’est pas toujours nécessaire de créer un modèle depuis zéro. Le transfert d’apprentissage consiste à réutiliser un réseau déjà entraîné, puis à l’adapter à un besoin plus ciblé. Cette approche peut réduire le volume d’exemples à préparer et le temps nécessaire pour obtenir un premier prototype. Elle reste toutefois dépendante de la proximité entre la tâche initiale du modèle et celle de votre entreprise.
Bon à savoir : certains services proposent une interface simple, mais leurs résultats et leurs conditions d’utilisation varient. Avant de leur confier des documents internes ou des données clients, contrôlez les modalités de conservation, les accès et les options disponibles pour votre niveau d’abonnement. Notre guide pour choisir un site d’IA gratuit aide à comparer les critères pratiques.
Un pilote utile doit avoir une durée et un périmètre raisonnables. Par exemple, l’entreprise peut traiter d’abord une catégorie de courriels pendant quelques semaines et comparer les résultats avec la méthode actuelle. Elle pourra ainsi observer les erreurs, recueillir l’avis des employés et vérifier si le gain de temps reste réel une fois les vérifications prises en compte.
La gouvernance doit suivre le même principe de simplicité. Indiquez qui utilise le système, quelles informations lui sont transmises, quelles décisions restent humaines et qui intervient lorsqu’un résultat paraît incorrect. Ces règles renforcent la confiance de l’équipe et facilitent les ajustements lorsque l’outil évolue.
Le deep learning est donc une approche puissante, mais ni magique ni indispensable à tous les projets. Il apprend des représentations complexes à partir de données et permet des progrès remarquables en vision, en langage et en audio. Pour une entreprise, sa pertinence se juge à l’aune d’un besoin réel, de données maîtrisées et d’un bénéfice vérifiable.
Pour aller plus loin, les ressources de SAP sur le fonctionnement du deep learning complètent cette définition. Si votre priorité concerne plutôt l’automatisation téléphonique, demandez une démonstration d’AirAgent afin d’évaluer un cas d’usage concret avant toute décision.
Quelle est la différence entre le deep learning et le machine learning ?
Le machine learning désigne les méthodes qui apprennent à partir de données. Le deep learning en est une branche qui utilise des réseaux de neurones comportant plusieurs couches pour apprendre des caractéristiques complexes.
Pourquoi parle-t-on d’apprentissage profond ?
Le terme fait référence aux nombreuses couches d’un réseau de neurones. Chaque couche transforme les données et peut apprendre des caractéristiques plus abstraites que les couches précédentes.
Le deep learning convient-il à toutes les entreprises ?
Non. Il est surtout pertinent pour des tâches complexes reposant sur des images, du texte, de l’audio ou de grands volumes de données. Pour des besoins simples, une méthode classique peut être plus économique et plus facile à interpréter.
Faut-il beaucoup de données pour utiliser le deep learning ?
Les réseaux profonds tirent généralement avantage de nombreux exemples de qualité. Un modèle préentraîné peut réduire les besoins d’apprentissage, mais il faut tout de même vérifier ses résultats sur des données représentatives de votre activité.